Quand la fenêtre se referme : repenser nos pipelines à l'ère des attaquants augmentés par l'IA

Oct 22, 2026 · @Tonux Samb
Pendant des années, nous avons construit nos applications et nos pipelines en supposant qu'entre la découverte d'une faille et son exploitation, il nous restait du temps. Ce temps est en train de disparaître. L'IA ne rend pas les attaquants plus intelligents, elle les rend plus rapides et plus nombreux. Dans cet article, je décris ce qui ne tient plus dans nos méthodes classiques et les pratiques que je considère désormais comme des valeurs par défaut pour toute équipe qui livre du PHP, du Node.js ou n'importe quelle stack moderne.
Un mardi matin comme les autres
Prenons un scénario que beaucoup d'entre nous ont vécu, sous une forme ou une autre.
Un mardi matin, une alerte de sécurité tombe sur une bibliothèque que vous utilisez dans trois projets clients. Rien d'alarmant à première vue : la note est « haute », pas « critique ». Vous créez un ticket, vous le placez dans le sprint suivant et vous retournez à la fonctionnalité que le client attend pour vendredi.
Le jeudi, les journaux d'un des serveurs montrent des requêtes étranges. Quelqu'un a déjà écrit un exploit fonctionnel, l'a automatisé et balaie Internet à la recherche de cibles. Entre la publication du correctif et la première tentative d'exploitation sur votre application, il s'est écoulé moins de deux jours.
Il y a dix ans, ce même scénario se serait étalé sur plusieurs semaines. La faille aurait d'abord intéressé quelques chercheurs. Un exploit public serait peut-être apparu, puis des outils automatisés et seulement ensuite des attaques de masse. Pendant tout ce temps, votre ticket aurait eu le temps de remonter dans le backlog.
Ce qui a changé, ce n'est pas la nature des failles. PHP et Node.js n'ont pas soudain été écrits plus mal. Ce qui a changé, c'est le coût de leur exploitation. Et quand le coût d'une activité s'effondre, le nombre de gens qui la pratiquent augmente.
La fenêtre d'exploitation
J'appelle fenêtre d'exploitation la période qui sépare le moment où une faille devient connue du moment où elle est activement exploitée contre des systèmes comme le vôtre. C'est l'espace dans lequel une équipe peut corriger sans être attaquée. Toute notre organisation du travail, souvent sans qu'on le dise, repose sur la taille de cette fenêtre.
Pendant longtemps, elle était large. Écrire un exploit demandait de l'expertise: lire le correctif, comprendre le code vulnérable, reproduire le contexte, contourner les protections. Peu de personnes savaient le faire et elles avaient mieux à faire que de s'attaquer à l'application d'une PME.
Les modèles de langage ont changé cette équation de trois façons.
- Lire un correctif devient trivial. On donne le diff d'un patch de sécurité à un modèle et il explique ce qui était vulnérable et comment le déclencher. Ce qu'un expert faisait en une journée prend maintenant quelques minutes.
- Le passage à l'échelle est gratuit. Un attaquant peut faire analyser des milliers de dépôts publics, de paquets npm ou de plugins PHP à la recherche de motifs dangereux, sans fatigue et sans salaire.
- Le niveau d'entrée baisse. Quelqu'un qui n'aurait jamais su écrire un exploit peut maintenant en obtenir un qui fonctionne, ou presque.
Le résultat est que la fenêtre se referme. Elle ne disparaît pas complètement mais elle passe des semaines aux jours, parfois aux heures.
Ce que l'IA ne change pas
Il serait faux de dire que l'IA crée de nouvelles catégories de failles. Les injections SQL, les désérialisations dangereuses, la pollution de prototype en JavaScript, les dépendances compromises : tout cela existait avant. L'IA agit comme un accélérateur, pas comme un inventeur. C'est plutôt une bonne nouvelle, car cela signifie que les défenses que nous connaissons restent valables. Ce qui doit changer, c'est la vitesse et la systématisation avec lesquelles nous les appliquons.
Ce qui ne tient plus
Quand j'observe la façon dont la plupart des équipes que je croise gèrent la sécurité, je retrouve presque toujours les mêmes hypothèses implicites. Elles étaient raisonnables quand la fenêtre était large. Elles ne le sont plus.
« La sécurité, c'est l'audit avant la mise en production. » On fait passer un outil ou un prestataire une fois par an, ou avant une grosse livraison. Entre deux audits, on suppose que rien ne bouge. Or le code change à chaque commit et les dépendances changent même quand on ne touche à rien : une bibliothèque saine aujourd'hui peut faire l'objet d'une alerte demain.
« Les mises à jour de dépendances, on les fera quand on aura le temps. » Monter de version est perçu comme une corvée risquée, qu'on repousse. On accumule alors des mois, parfois des années, de retard. Le jour où un correctif urgent arrive, il faut franchir d'un coup trois versions majeures et ce qui devait prendre une heure prend une semaine.
« Ce qui vient de npm ou de Packagist est digne de confiance. » On ajoute une dépendance parce qu'elle est populaire et qu'elle résout notre problème. On ne se demande pas qui la maintient, ce que font ses scripts d'installation, ni ce qu'elle tire derrière elle.
« Le pipeline n'est qu'un outil interne. » On protège la production, mais la CI dispose souvent de secrets bien plus puissants : clés de déploiement, accès au cloud, jetons de publication. Elle est rarement traitée comme un système de production à part entière.
Aucune de ces hypothèses n'est stupide. Chacune représentait un compromis acceptable entre effort et risque. Mais le risque a changé de prix, et le compromis doit être recalculé.
Des dépendances : de la confiance par défaut à la confiance vérifiée
Si je ne devais retenir qu'un seul chantier, ce serait celui-ci. Dans une application Node.js typique, le code que votre équipe a réellement écrit représente une petite fraction de ce qui s'exécute en production. Le reste vient de centaines de paquets, écrits par des inconnus, mis à jour à des rythmes que vous ne contrôlez pas. Côté PHP, Composer a apporté la même richesse et donc la même exposition.
Le vrai problème n'est pas le nombre de dépendances. C'est que nous leur accordons une confiance par défaut : tout ce qui est publié est considéré comme sûr jusqu'à preuve du contraire. Je propose de passer à une confiance vérifiée : rien n'entre sans un minimum de contrôles, et ces contrôles sont automatiques.
Concrètement, cela se traduit par quelques pratiques simples.
Verrouiller ce qui est installé. Le fichier de verrouillage (package-lock.json, pnpm-lock.yaml, composer.lock) est versionné, et la CI installe strictement ce qu'il contient avec npm ci ou composer install. Aucune résolution de version ne se fait pendant un build.
Laisser reposer les nouvelles versions. C'est une pratique contre-intuitive, mais l'une des plus efficaces. Les paquets compromis, ceux dans lesquels un attaquant a injecté du code malveillant, sont généralement détectés et retirés en quelques jours. Si vous refusez d'installer toute version publiée depuis moins de quelques jours, vous évitez une grande partie de ces attaques sans rien faire d'autre. Les gestionnaires de paquets récents et les outils de mise à jour automatique comme Renovate permettent de régler ce délai.
Désactiver les scripts d'installation. Les scripts postinstall s'exécutent sur la machine du développeur et dans la CI, avec leurs accès. Ils sont l'un des vecteurs préférés des paquets malveillants. Les désactiver par défaut et n'autoriser que ceux que vous avez examinés réduit fortement cette surface.
Savoir ce qu'on embarque. Chaque build devrait produire un SBOM, un inventaire lisible par une machine de tous les composants inclus. Son intérêt se révèle le jour où une faille est annoncée : au lieu de fouiller dix dépôts à la main, vous interrogez vos inventaires et savez en quelques minutes quels projets sont concernés.
Faire passer les paquets par un registre interne. Un proxy comme Verdaccio ou Nexus vous donne un point de contrôle unique. Vous y appliquez vos règles, vous gardez une copie de ce qui a été installé, et vous ne dépendez plus entièrement de la disponibilité du registre public.
Combien de dépendances ?
On me demande souvent s'il faut réduire le nombre de dépendances. Ma réponse est oui, mais pas par principe. Chaque dépendance est un contrat de confiance avec quelqu'un que vous ne connaissez pas. Avant d'en ajouter une, je me pose une question simple : est-ce que ce qu'elle m'apporte vaut le risque de lui confier l'exécution de code dans ma production ? Pour un framework, presque toujours. Pour une fonction de dix lignes, rarement.
Le pipeline est lui-même une cible
Nous avons tendance à voir la CI/CD comme de la plomberie : utile, invisible, et donc peu surveillée. C'est précisément ce qui en fait une cible de choix. Un pipeline compromis permet d'injecter du code dans tout ce qui sera déployé ensuite, avec la signature de votre équipe. Pour un attaquant, c'est bien plus rentable que de forcer une seule application.
Je pars donc d'un principe : le pipeline est un système de production, et il mérite les mêmes égards.
Épingler les actions par empreinte. Dans GitHub Actions comme dans GitLab CI, on réutilise volontiers des actions ou des modèles tiers référencés par un tag, @v4 par exemple. Un tag peut être déplacé vers un autre commit, y compris malveillant. Les référencer par leur empreinte SHA garantit que ce qui s'exécute est exactement ce que vous avez examiné.
Remplacer les secrets permanents par des identités éphémères. Une clé d'accès au cloud stockée dans les variables de la CI est valable jusqu'à ce que quelqu'un pense à la révoquer. Avec OIDC, le pipeline obtient un jeton valable quelques minutes, limité à ce job précis. S'il fuit, il ne sert presque à rien.
Donner le minimum de droits à chaque job. Le job qui lance les tests n'a pas besoin de pouvoir publier un paquet ni pousser sur la branche principale. Déclarer explicitement les permissions de chaque étape coûte quelques lignes de configuration et limite les dégâts en cas de compromission.
Utiliser des runners éphémères. Un runner qui sert à tous les builds pendant des mois accumule des caches, des fichiers et parfois des secrets. Un runner créé pour un job puis détruit ne laisse rien derrière lui.
Signer ce qu'on produit. Signer les images et les artefacts, avec cosign par exemple, et attacher une attestation de provenance permet à l'étape de déploiement de vérifier que ce qu'elle reçoit a bien été construit par votre pipeline, à partir de votre code. Le cadre SLSA décrit bien les niveaux de garantie qu'on peut viser progressivement.
Patcher vite exige de tester bien
Si la fenêtre se referme, la réponse évidente est de corriger plus vite. Mais je vois beaucoup d'équipes buter sur ce point, et la raison est rarement technique. Elles ne patchent pas lentement par négligence. Elles patchent lentement parce qu'elles ont peur de casser quelque chose.
Cette peur est légitime. Monter une dépendance de version, c'est modifier du code qu'on n'a pas écrit et qu'on ne connaît pas. Sans filet, chaque mise à jour devient un pari, et personne n'aime parier le vendredi après-midi.
C'est pour cela que je considère la suite de tests comme un outil de sécurité, au même titre qu'un scanner. Une équipe qui dispose de tests fiables peut laisser un outil comme Renovate ou Dependabot ouvrir une demande de fusion pour chaque correctif, laisser la CI la valider, et fusionner automatiquement les mises à jour mineures si tout passe au vert. Les mises à jour deviennent un flux continu de petits changements sans histoire, au lieu d'un grand chantier redouté.
L'inverse est tout aussi vrai. Une équipe sans tests ne pourra pas patcher vite, quels que soient ses outils. Dans ce cas, le premier investissement de sécurité n'est pas un scanner de plus, ce sont des tests sur les parcours critiques.
Je recommande aussi de rendre le délai de correction explicite, en fixant des engagements par niveau de gravité, par exemple :
| Gravité | Délai de correction cible |
|---|---|
| Critique, exploitée activement | 24 à 48 heures |
| Haute | 7 jours |
| Moyenne | 30 jours |
| Faible | Au fil de l'eau |
Ces chiffres ne sont pas une norme ; chaque équipe doit trouver les siens. Ce qui compte, c'est qu'ils existent, qu'ils soient mesurés, et que le temps moyen de correction devienne un indicateur suivi au même titre que la vélocité ou le taux d'erreurs.
Supposer la brèche
Toutes les pratiques précédentes visent à empêcher une faille d'arriver en production, ou à la corriger vite. Il faut pourtant être honnête : aucune n'est parfaite. Un jour, une faille passera. Une faille encore inconnue, un paquet compromis qui n'a pas encore été détecté, une erreur de configuration.
Le mouvement « shift left », qui consiste à déplacer les contrôles le plus tôt possible dans le cycle de développement, a été très utile. Mais il a parfois donné l'impression qu'une fois le code validé en CI, le travail de sécurité était fini. Je préfère penser en deux temps : réduire la probabilité qu'une faille atteigne la production, et réduire l'impact quand cela arrive malgré tout.
Réduire l'impact, c'est d'abord réduire ce qu'un attaquant peut faire une fois entré.
- Des images minimales. Une image de conteneur sans shell, sans gestionnaire de paquets et sans outils superflus, comme les images distroless, laisse peu de choses à exploiter.
- Pas de root. Le processus de l'application tourne avec un utilisateur sans privilèges, sur un système de fichiers en lecture seule autant que possible.
- Des secrets dans un coffre. Les secrets vivent dans un gestionnaire dédié, avec des droits limités et une rotation régulière, pas dans des fichiers
.envcopiés de serveur en serveur. - Un réseau segmenté. L'application web n'a pas besoin de parler à tout le réseau interne. Limiter les flux sortants rend aussi l'exfiltration de données plus difficile.
C'est ensuite voir ce qui se passe. Une application compromise que personne ne surveille peut le rester des mois. Des journaux centralisés, des alertes sur les comportements anormaux, comme un pic d'erreurs d'authentification, des requêtes sortantes inhabituelles ou un processus inattendu dans un conteneur, sont ce qui transforme une compromission silencieuse en incident géré. Un pare-feu applicatif et une limitation de débit ne remplacent pas un correctif, mais ils peuvent gagner les quelques heures nécessaires pour l'appliquer.
L'IA joue des deux côtés
Il serait étrange de présenter l'IA uniquement comme une arme entre les mains des attaquants. Les mêmes capacités sont disponibles pour nous, et ce serait une erreur de ne pas s'en servir.
Là où je la trouve la plus utile aujourd'hui, c'est en revue de code orientée sécurité. Faire relire chaque demande de fusion par un modèle à qui l'on demande explicitement de chercher des failles attrape une partie des erreurs que des humains pressés laissent passer : une entrée utilisateur non validée, une requête construite par concaténation, un contrôle d'accès oublié sur une nouvelle route. Elle ne remplace pas la revue humaine, mais elle la rend plus systématique.
Elle est aussi précieuse pour trier le bruit. Les scanners de dépendances et d'analyse statique produisent beaucoup d'alertes, dont une bonne partie ne concerne pas réellement votre usage. Un modèle peut aider à déterminer si le code vulnérable est effectivement atteint dans votre application, et donc ce qui mérite d'être traité en priorité.
Enfin, elle aide à modéliser les menaces en début de projet, et à préparer des tests d'intrusion plus ciblés avant les livraisons importantes.
Mais l'IA introduit aussi ses propres risques dans notre manière de produire du code, et il faut les regarder en face.
Le code généré n'est pas du code relu. Un assistant produit du code plausible, qui compile et qui passe souvent les tests. Il reproduit aussi, sans le dire, les mauvaises pratiques présentes dans ses données d'entraînement. Le code généré doit passer par les mêmes contrôles que le code écrit à la main, et ma règle est simple : on ne fusionne pas ce qu'on ne comprend pas.
Les dépendances inventées. Les assistants proposent parfois d'installer des paquets qui n'existent pas. Des attaquants ont compris le phénomène et enregistrent ces noms sur les registres publics pour y placer du code malveillant ; on parle de slopsquatting. Toute nouvelle dépendance suggérée par une IA doit être vérifiée : existe-t-elle depuis longtemps, qui la maintient, combien de projets l'utilisent ?
Les agents qui agissent. Quand un agent de code a le droit d'exécuter des commandes, d'installer des paquets ou de pousser du code, il devient un acteur de votre chaîne de production. Il doit recevoir le même traitement qu'un job de CI : droits minimaux, environnement isolé, et rien qui ne parte en production sans validation.
Par où commencer
En lisant tout cela, on peut se sentir découragé. La liste est longue, et la plupart des équipes que je connais ont déjà du mal à livrer leurs fonctionnalités à temps. Je ne crois pas qu'il faille tout faire d'un coup.
J'aime beaucoup la notion de valeur par défaut raisonnable : une pratique qu'on applique systématiquement, sauf si un contexte particulier justifie de s'en écarter. Personne ne débat plus de l'utilité du contrôle de version. Mon pari est que, d'ici peu, la plupart des pratiques décrites ici auront le même statut. Autant commencer à les installer comme telles, une par une.
Si je devais accompagner une équipe qui part de zéro, voici l'ordre que je suivrais, du plus rentable au plus avancé :
- Détecter les secrets dans le code et l'historique. C'est rapide, et une clé exposée est la faille la plus facile à exploiter qui soit.
- Verrouiller les dépendances et activer l'audit en CI, avec un blocage sur les vulnérabilités critiques et hautes uniquement.
- Automatiser les mises à jour avec Renovate ou Dependabot, en ajoutant un délai de quarantaine sur les nouvelles versions.
- Durcir le pipeline : actions épinglées, permissions minimales, OIDC à la place des secrets permanents.
- Ajouter l'analyse statique et la revue assistée sur chaque demande de fusion.
- Générer un SBOM et signer les artefacts, puis vérifier la signature au déploiement.
- Durcir l'exécution et surveiller : images minimales, utilisateur sans privilèges, alertes sur les comportements anormaux.
Un dernier conseil sur ce point : ne bloquez que ce qui compte vraiment. Un pipeline qui échoue pour chaque alerte de faible gravité apprend surtout aux développeurs à le contourner. Mieux vaut bloquer sur peu de choses, de façon fiable, et transformer le reste en tickets.
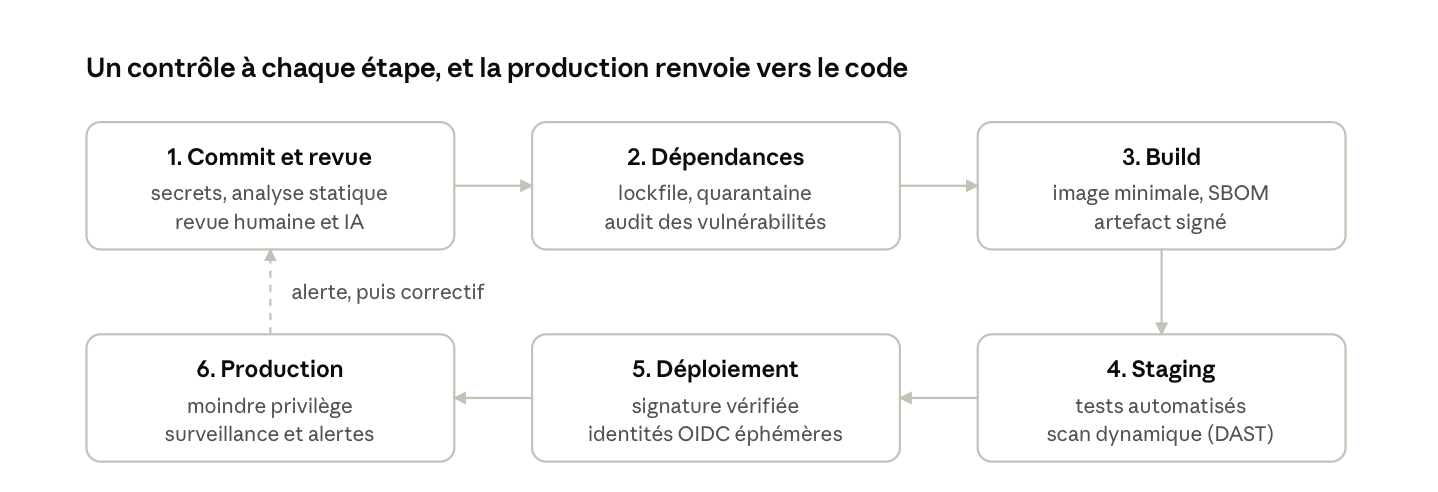
Une fois en place, le pipeline forme une boucle: ce que la surveillance détecte en production revient sous forme de correctif dans le code, et repasse par tous les contrôles.
Une question de rythme
Si je devais résumer cet article en une idée, ce serait celle-ci : la sécurité n'est plus un événement, c'est un rythme. Elle ne se joue plus lors d'un audit annuel ou d'une revue avant la mise en production. Elle se joue à chaque commit, à chaque mise à jour de dépendance, à chaque déploiement.
Il y a quelque chose de familier dans ce constat. Il y a vingt ans, nous avons compris que l'intégration ne devait pas être une phase douloureuse en fin de projet, mais une activité continue, faite par petits pas. Puis nous avons compris la même chose pour la livraison. Je crois que la sécurité suit exactement le même chemin, et que l'IA ne fait qu'accélérer une évolution qui était déjà en cours.
La bonne nouvelle, c'est que les équipes qui ont déjà adopté l'intégration et la livraison continues ont fait la moitié du chemin. Elles ont des tests, de l'automatisation, l'habitude des petits changements. Il leur reste à y faire entrer la sécurité comme une propriété du pipeline, plutôt que comme une étape à part.
La fenêtre se referme. Notre réponse ne doit pas être la panique, mais la cadence.
Remerciements
Cet article doit beaucoup aux échanges avec les équipes et les développeurs que j'accompagne et dont les questions m'ont obligé à clarifier ces idées. Si vous avez des retours ou des expériences qui contredisent ce que j'écris ici, j'aimerais les lire.
TakkJokk,